 kengdevParlons de votre projet
Mis à jour le 2026-09-10
Le context engineering consiste à sélectionner, structurer et limiter les informations transmises au modèle : instructions, documents, mémoire et outils. Il aide à fiabiliser un agent, sans garantir une réponse identique à chaque exécution.
Rendre les réponses assez stables pour qu'un process métier puisse s'appuyer dessus.
Plus de contexte ne veut pas dire meilleure réponse. Au-delà d'un certain seuil, la qualité se dégrade.
Prod, pas session IDE
En production, le context engineering dépasse largement le compact et le clear d'une session Claude Code. Il s'agit de concevoir tout ce qui arrive dans le modèle quand un agent métier tourne: le system prompt, les outils, les documents, l'historique et les politiques. L'hygiène de session IDE a son article dédié.
Un contexte incomplet, contradictoire ou trop volumineux peut faire échouer une tâche même avec un modèle performant. Il faut donc examiner les informations injectées autant que le choix du modèle, puis mesurer les effets sur un corpus de test.
Le goulot se déplace donc du choix du modèle vers le contexte envoyé à chaque requête, de façon rejouable. Et sans la troisième brique, celle du contrôle (allowlist, logs, validation humaine), tu as juste un POC ou une démo.
Quatre stratégies: Write, Select, Compress, Isolate
Un cadre largement repris, formalisé par LangChain pour les agents, organise le travail en quatre mouvements:
- Write: persister le contexte hors de la fenêtre (state machine, base de tickets, handoff fichier, mémoire projet). La fenêtre est finie, donc ce qui doit survivre entre deux appels s'écrit ailleurs.
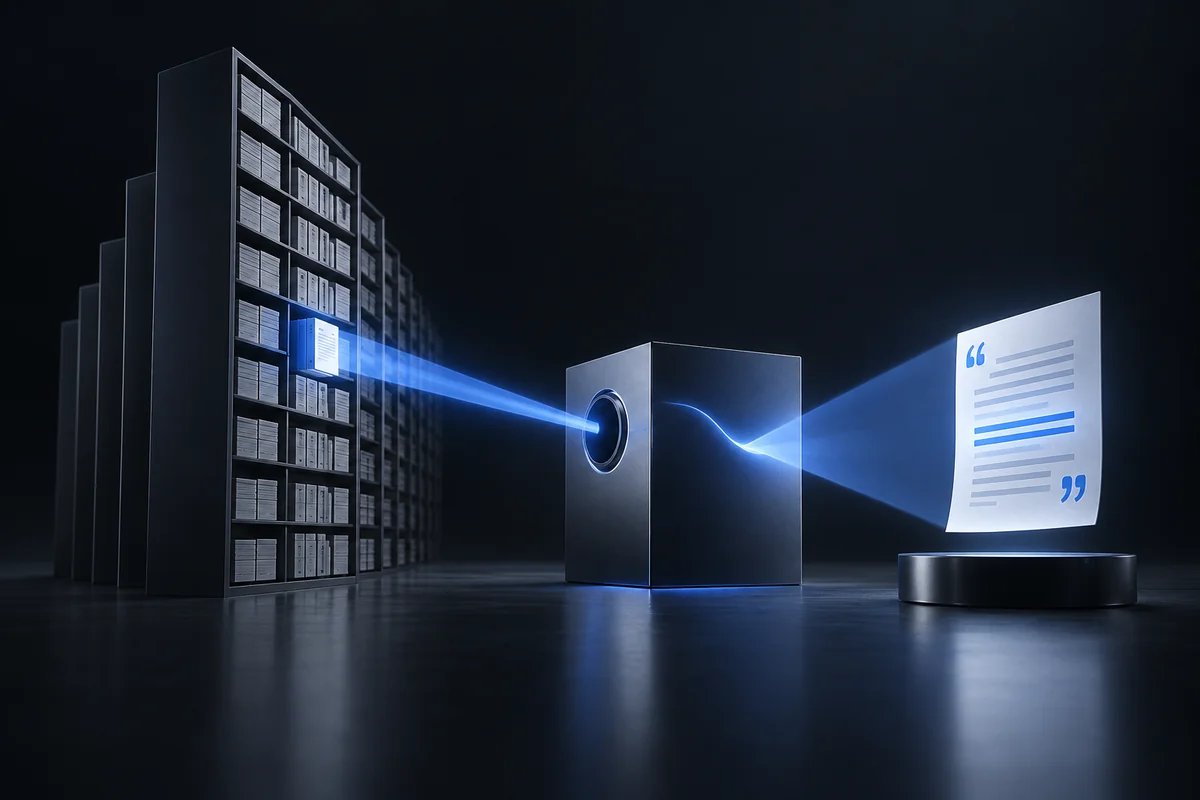
- Select: ne récupérer que le pertinent, avec un RAG borné, des filtres, un top-k et des règles d'inclusion. Un Drive entier n'est pas un contexte.
- Compress: résumer, tronquer les sorties d'outils, garder les N derniers tours bruts et un résumé du reste (hybrid sliding window). Sur les tâches longues, compresse d'abord.
- Isolate: séparer les contextes par agent ou par sous-tâche, via des subagents. L'orchestrateur n'avale pas l'historique de recherche complet.
Ce qu'il y a dans une context window
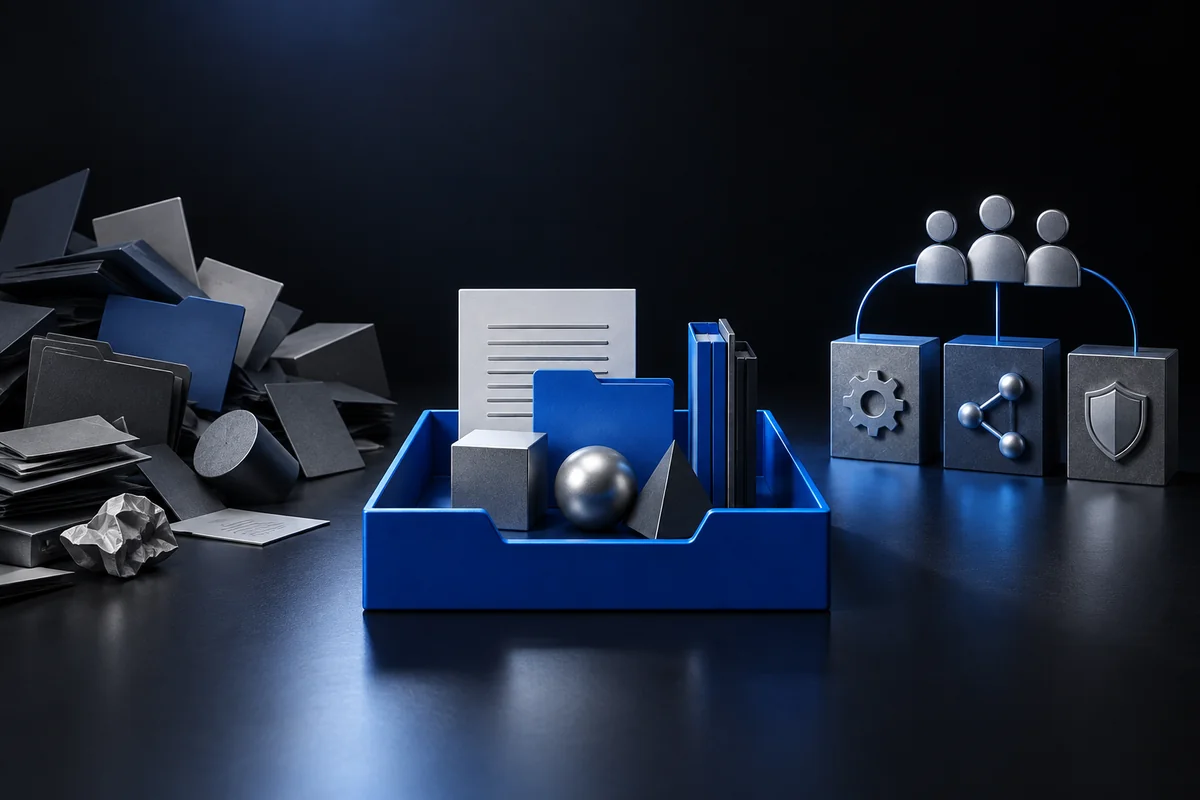
Quatre piliers pratiques reviennent dans les guides agents:
- Les instructions: le system prompt et le cadrage
- Le retrieval: le RAG et les documents
- La mémoire: la conversation à court terme, le projet à long terme
- Les outils: le function calling, de plus en plus via MCP
Les outils bruyants, comme les JSON énormes ou les logs bruts, pourrissent le contexte aussi vite qu'un chat trop long. En pratique, on filtre, on résume et on borne la taille des réponses d'outils.
Si tu branches plusieurs serveurs MCP, compte les tokens des schémas d'outils avant toute requête utilisateur. Ce coût d'entrée est souvent sous-estimé.
Pourrissement de contexte et qualité
La capacité à retrouver une information peut varier selon sa position et la longueur du contexte. Cela dépend du modèle et de la tâche : mesure la qualité sur tes propres documents plutôt que de fixer un seuil de remplissage universel.
Sur un agent métier, ça donne un prix inventé, une policy oubliée ou une doc obsolète citée. La contre-mesure combine un corpus versionné, des citations obligatoires, un plafond de documents, un reset d'état entre les tickets et de l'isolation pour la recherche lourde.
Versionne aussi les prompts, les templates, les pipelines de retrieval et les définitions d'outils comme du code. Un « petit changement » non daté rend le debug impossible.
Skills, routing, évaluation
Des skills et des playbooks versionnés rendent la procédure explicite. Un déclencheur programmé peut fiabiliser le choix du workflow ; il ne rend pas les réponses du modèle déterministes.
Si l'agent sert plusieurs domaines, ajoute du routing, même de simples règles par mots-clés au début, pour couper le bloat avant d'investir dans un classifieur LLM.
Enfin, évalue avec un jeu de 30-50 cas gold qui associent une entrée à la sortie ou à la classe d'action attendue. Mesure les tokens par ticket, le taux d'échec et le taux d'édition humaine. Sans golden set, chaque « amélioration » reste une opinion.
Checklist prod
Avant de parler de production, vérifie ces huit points:
- Les sources injectées sont listées
- Write, Select, Compress et Isolate sont appliqués
- La taille des réponses d'outils est plafonnée
- Les tokens des schémas MCP sont comptés
- Les prompts, templates et pipelines sont versionnés
- Une validation humaine couvre les sorties à impact
- Un budget mensuel est fixé
- Un jeu de cas gold existe
Si un point manque, tu optimises encore au feeling. C'est acceptable pour un spike, pas pour de la production client.
Si vous voulez un audit de contexte sur un agent métier, on peut cadrer en 20-40 minutes.
Questions fréquentes
Context engineering vs prompt engineering ?
Le prompt engineering optimise l'instruction. Le context engineering orchestre tout ce qui remplit la fenêtre: les données, les outils, la mémoire et le filtrage. En production, le second domine souvent le ROI.
Lien avec Claude Code compact/clear ?
La physique est la même, le périmètre change. Compact et clear gèrent une session IDE; cet article couvre l'agent métier rejouable. Le détail vit dans l'article Claude Code.
Faut-il toujours du RAG ?
Non. Le RAG aide quand le corpus est large et changeant, côté Select. Pour des règles stables, une doc courte et versionnée bat un index bruyant.
Comment réduire la facture tokens ?
Applique un Select strict, compresse les sorties d'outils, isole les subagents, cache les préfixes stables, route entre petit et grand modèle, et mesure le coût par ticket.
Qui ownership le contexte ?
Chaque agent ou domaine a besoin d'un owner produit ou engineering. Sans owner, le corpus pourrit.
Par quoi commencer demain ?
Prends un agent existant, liste le contexte injecté, coupe 30% de bruit, puis mesure la qualité et le coût sur 20 cas.
Sources et repères
- Effective context engineering for AI agentsAnthropic
Documentation primaire à consulter pour les caractéristiques et évolutions du produit.
- Context engineering for agentsLangChain
Documentation primaire à consulter pour les caractéristiques et évolutions du produit.