 kengdevParlons de votre projet
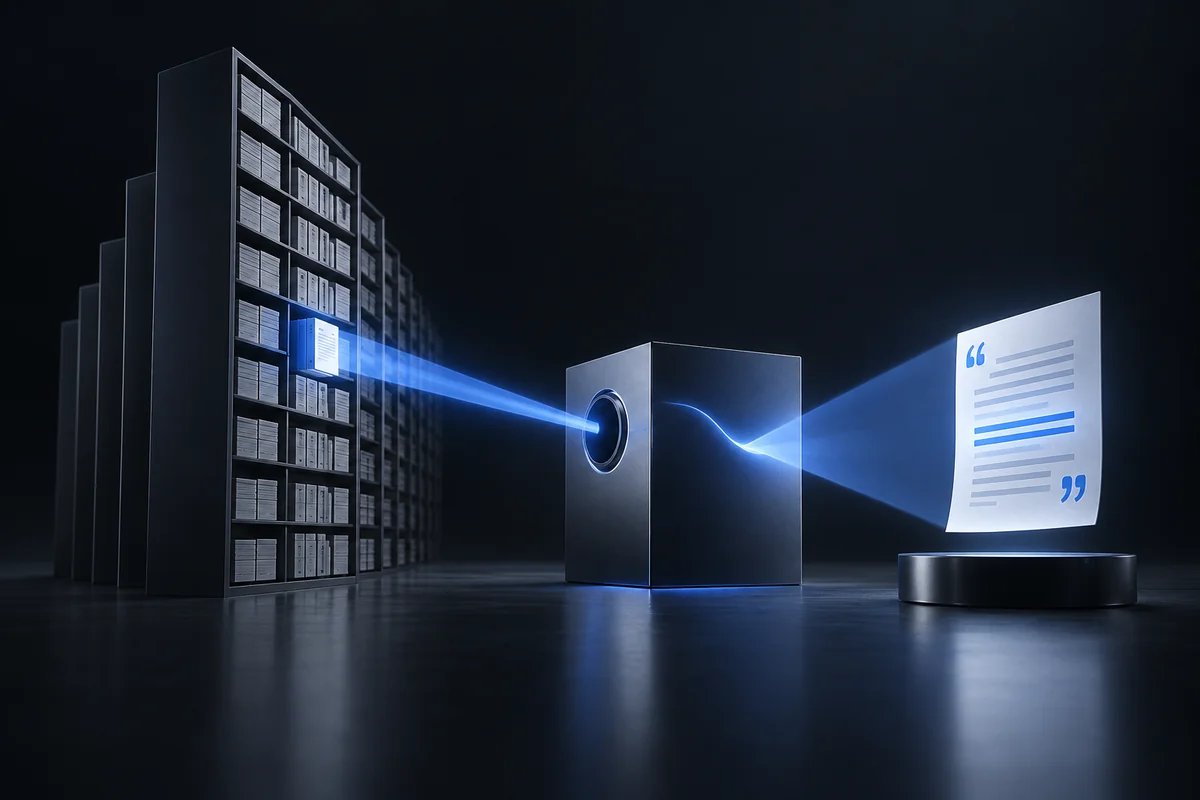
Un RAG et un fine-tuning répondent à deux questions différentes. Un RAG va chercher des faits à jour au moment où la question est posée, sans toucher au modèle. Le fine-tuning, à l'inverse, modifie durablement son comportement: on lui montre des exemples, et ils finissent dans les poids ou dans un adaptateur.
Choisir entre les deux sur des critères vérifiables, ou décider en connaissance de cause de les combiner.
Si le problème porte sur la connaissance, prends un RAG. S'il porte sur le format ou le ton, le fine-tuning se justifie.
RAG vs fine-tuning: deux leviers, deux jobs
Les deux approches ne jouent pas le même rôle. Un RAG va chercher des faits à jour au moment où la question est posée, sans toucher au modèle. Le fine-tuning, à l'inverse, modifie durablement le comportement du modèle: on lui montre des exemples, et ils finissent dans les poids ou dans un adaptateur.
Le bon réflexe consiste donc à partir de ton échec mesuré, pas de la tech la plus en vogue. L'échec typique, c'est le modèle qui ne connaît pas ton catalogue. Dans ce cas, commence par un RAG, voire par une simple recherche. Si le modèle connaît les faits mais sort le mauvais format ou le mauvais ton, alors un fine-tuning, ou simplement des prompts et des skills bien construits, peuvent gagner.
Beaucoup d'équipes lancent un fine-tuning pour masquer un corpus mal rangé. Ça coûte cher, et le résultat se périme dès que les prix ou les procédures changent.
Grille de décision en 6 questions
Avant de trancher entre RAG et fine-tuning, passe ton cas dans cette grille. Chaque question pointe vers un levier différent selon ta réponse.
| Question | Si oui | Si non |
|---|---|---|
| 1. Les faits changent-ils chaque semaine ? | RAG ou base à jour, pas de retrain mensuel | Le fine-tuning reste envisageable |
| 2. As-tu des données d'exemples propres, et les droits dessus ? | Un fine-tune devient possible | RAG + prompts |
| 3. Le risque est-il juridique ou client ? | Retrieval + citations + validation humaine d'abord | Plus de marge pour expérimenter |
| 4. Le besoin porte-t-il sur le style, la langue métier, un format de ticket ? | Skills et prompts, éventuellement un fine-tune léger | C'est un problème de connaissances: RAG |
| 5. Peux-tu servir un modèle custom (budget ops) ? | Le fine-tune reste une option | API + RAG |
| 6. As-tu un jeu d'évaluation ? | Tu peux comparer les deux options | Rien n'est validé, ni l'un ni l'autre |
Fais ensuite le score. Si trois réponses ou plus poussent vers les documents et la fraîcheur, commence par un RAG. Si ton corpus est déjà impeccable et que l'échec est purement comportemental, regarde du côté du fine-tuning.
Coûts cachés des deux options
Un RAG semble économique au départ, mais il traîne des coûts récurrents que les équipes data sous-estiment souvent:
- L'ingestion et le nettoyage des documents
- Le stockage des vecteurs et la ré-indexation à chaque mise à jour
- L'évaluation du retrieval
- La gestion des droits d'accès (ACL) et des citations
Le fine-tuning a les siens, encore moins visibles:
- La collecte et la labellisation des exemples
- Les runs d'entraînement, puis l'éval de régression (le modèle « oublie » des cas)
- Le serving d'un modèle distinct et le versioning des adapters
- Le risque de fuite des données d'entraînement
Pour comparer honnêtement, chiffre les deux options sur 90 jours: euros, jours-homme et incidents. Même un fine-tune « offert » par un vendor se paie ensuite en éval et en maintenance.
Patterns qui marchent ensemble
En pratique, les deux leviers se combinent bien. Le RAG s'occupe des faits, le system prompt et les skills portent le process. Un fine-tune, ou un simple adaptateur, n'intervient que sur le format de sortie, une fois le retrieval stabilisé. Sur un agent, la répartition est la même: des tools déterministes pour le calcul, un RAG pour la doc, une validation humaine avant l'envoi.
Ce qu'il faut éviter, c'est le double système que personne ne gouverne: un fine-tune opaque d'un côté, un RAG jamais évalué de l'autre. Un seul pipeline mesurable bat deux bricolages.
Si tu tournes en local avec des modèles open weights, le fine-tune local reste possible mais lourd. Là aussi, le premier levier est presque toujours un RAG sur ton corpus interne (voir ia-locale et l'actu open weights).
Pièges classiques
Les mêmes erreurs reviennent dans la plupart des projets:
- Fine-tuner sur des FAQ qui ne sont plus à jour
- Mesurer le succès au « vibe » de la démo plutôt qu'à une éval
- Ignorer les droits d'accès (ACL) dans le retrieval
- Croire qu'un fine-tune supprime le besoin de citations
- Changer de modèle et de corpus le même jour, sans baseline
La contre-mesure tient en une phrase: fige une baseline, ne change qu'une variable à la fois, tiens un journal d'expériences, et nomme un owner pour les données et un autre pour le modèle.
Décision en une page (template)
Pour arbitrer proprement, une page suffit. Elle contient:
- Le contexte et l'échec mesuré
- Les trois options: RAG, fine-tune, prompts et skills seuls
- Le coût à 90 jours et le risque de chaque option
- Le protocole d'éval, la décision go / no-go et la date de revue
Si le go tombe sur le RAG, enchaîne avec le guide RAG LLM. Si c'est le fine-tuning, impose une éval de non-régression et un plan de retrain. Et si les deux se justifient, séquence-les: le RAG d'abord.
Si vous voulez arbitrer RAG vs fine-tuning sur un cas réel, on peut cadrer la décision ensemble en 20-40 minutes.
Questions fréquentes
RAG ou fine-tuning: lequel en premier ?
Dans la majorité des PME, le RAG (ou une simple recherche avec un bon prompt) vient en premier. Le fine-tuning arrive quand l'échec restant est comportemental et que tes données d'exemples sont propres.
Le fine-tuning remplace-t-il le RAG ?
Il le remplace rarement dès que les faits bougent: les poids d'un modèle ne font pas une base documentaire en temps réel.
Peut-on combiner les deux ?
Oui, et c'est même le pattern le plus courant: le RAG porte le fond, le fine-tune (ou un adaptateur) porte le format. Garde un seul système d'éval pour les deux.
Combien d'exemples pour un fine-tune utile ?
Tout dépend de la tâche, mais la qualité prime sur la quantité. Quelques centaines d'exemples propres battent des milliers de lignes bruitées. Valide par une éval, pas au volume brut.
Et le prompt engineering ?
C'est toujours la première couche à essayer. Beaucoup de « on doit fine-tuner » se règlent avec des specs claires, des skills et des exemples few-shot versionnés.
Lien avec context engineering ?
Le context engineering décide de ce que tu mets dans la fenêtre du modèle, résultats du RAG compris. Le fine-tuning décide de ce que le modèle garde dans ses poids. Les deux sont complémentaires.